这是 2018 年一套生产环境 Proxmox VE 三节点超融合的现场记录:从建集群、装 Ceph Hammer、划 OSD、建资源池,到把 RBD 挂成共享存储,13 张截图都是当时在现场截的。原文是工作笔记,发布前清理了排版残留、修正了命令拼写,环境 IP 与主机名保持原样(内网地址,无敏感信息);当年版本已全部 EOL,文末补了 2026 年重做这件事该怎么做。
环境与目标
| 项目 | 配置 |
|---|---|
| 节点 | 3 台,Proxmox VE 3.4,主机名 cloud51 / cloud52 / cloud53 |
| 管理网段 | 10.0.0.51 – 10.0.0.53(/24) |
| 分布式存储 | Ceph Hammer 0.94.9,由 pveceph 管理 |
| 目标 | 三节点互为副本,虚机磁盘放共享存储,单节点故障不影响虚机运行与在线迁移 |
做法很直接:先用 pvecm 把三台机器组成一个集群,再用 pveceph 在三台机器上装一套 Ceph,把每台的 /dev/sdb 做成 OSD,最后在 Web 界面把 RBD 池挂成共享存储。这样虚机磁盘落在 Ceph 上,节点之间可以直接在线迁移,不需要本地盘互拷。
配置 Proxmox 虚拟化集群
主节点创建集群
在 cloud51 上执行(pvecm create [集群名]):
root@cloud51:~# pvecm create vclusters
在主节点创建集群,集群名 vclusters
从节点加入集群
在 cloud52、cloud53 上分别执行(pvecm add [主节点IP]),过程中按提示输入主节点的 root 密码:
root@cloud52:~# pvecm add 10.0.0.51
从节点加入集群:加入成功时会提示节点已写入集群配置
查看集群状态
root@cloud51:~# pvecm status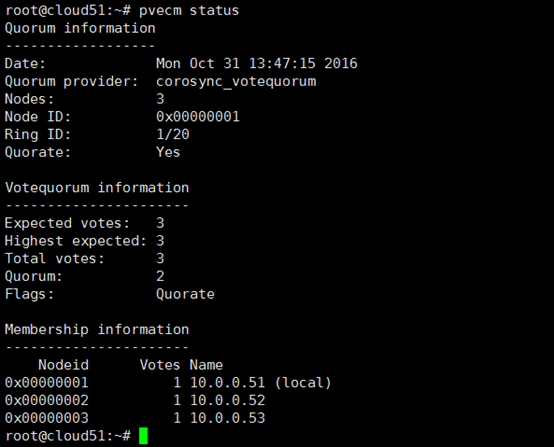
pvecm status:Quorum 正常,三个节点都在集群里
root@cloud51:~# pvecm nodes # 旧版写 pvecm node,新版为 nodes

查看集群成员节点列表
安装 Ceph 0.94.9(Hammer)集群存储
三个节点都装 Ceph 组件
pveceph install 会从 Proxmox 源装 Ceph 包,三台都要跑一遍:
root@cloud51:~# pveceph install --version hammer
root@cloud52:~# pveceph install --version hammer
root@cloud53:~# pveceph install --version hammer
pveceph install 安装 Ceph Hammer 组件
初始化存储网络
指定 Ceph 使用的网段与三台机器的管理网保持一致(生产环境建议给 Ceph 单独划 public / cluster 双网段):
root@cloud51:~# pveceph init --network 10.0.0.0/24创建三个 Monitor
root@cloud51:~# pveceph createmon
root@cloud52:~# pveceph createmon
root@cloud53:~# pveceph createmon
创建 OSD
每台机器拿一块独立盘做 OSD(这里是 /dev/sdb,实际按盘符调整)。注意 OSD 盘会被格式化,务必先确认盘符没写错。
root@cloud51:~# pveceph createosd /dev/sdb
root@cloud52:~# pveceph createosd /dev/sdb
root@cloud53:~# pveceph createosd /dev/sdb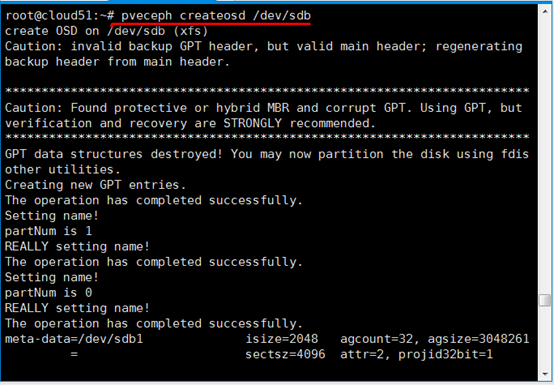
pveceph createosd 创建 OSD,完成后 Ceph 集群进入 active+clean
创建资源池(可选)
Ceph 默认有一个 rbd 池,直接用也可以;单独建一个业务池便于配额与权限区分:
root@cloud51:~# ceph osd pool create vclusters 128 128
create pool 命令输出

ceph -s 确认集群健康、三个 mon 就位
把 RBD 挂成 Proxmox 共享存储
在 Web 界面添加 RBD 存储
数据中心 → 存储 → 添加 → RBD,填写要点:
- ID:填
ceph(必填,且创建后不可改) - 资源池:
vclusters(默认rbd) - Monitor:
10.0.0.51 10.0.0.52 10.0.0.53,多个用空格分隔 - 添加节点:cloud51、cloud52、cloud53 全勾上,否则只有部分节点能用这块存储
- 内容:磁盘映像(虚机磁盘)

存储列表与「添加 RBD」入口

添加 RBD 表单:ID、资源池、三个 Monitor、三个节点
下发 Ceph 认证密钥
Proxmox 访问 Ceph 用的是 /etc/pve/priv/ceph/<存储ID>.keyring,把 admin keyring 复制过去并改名:
cd /etc/pve/priv
mkdir -p ceph
cp /etc/ceph/ceph.client.admin.keyring /etc/pve/priv/ceph/ceph.keyring
chmod 600 /etc/pve/priv/ceph/ceph.keyring
查看 RBD 存储配置信息

确认存储在各节点均已启用
验证存储状态
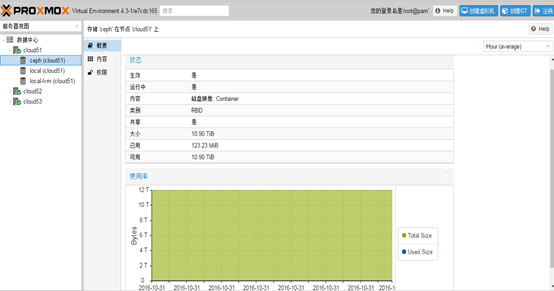
存储总览:ceph 共享存储可用容量 10.90 TB,三节点共用
这套架构解决了什么
- 没有单点。三副本落在三台机器上,任意一台整机宕机,虚机数据依然完整;配合 HA,虚机会在存活节点上自动拉起。
- 在线迁移不搬盘。虚机磁盘在共享存储里,迁移只搬内存状态,秒级完成,不用等几十 GB 的磁盘复制。
- 扩容按节点加。加一台机器 → 加入集群 → 装 Ceph → 加一个 OSD,容量与算力一起涨,不用停机重排。
- 成本是授权费为零。同样的三节点 HA + 共享存储能力,VMware 方案要按 CPU 买授权,这里是纯硬件投入。
2026 年重做这件事,会有什么不同
- 版本全部换代。PVE 3.4 与 Ceph Hammer 早已 EOL,如今是 PVE 8.x + Ceph Reef/Squid;
pveceph的 OSD 创建参数也变了(可指定--db_dev把 RocksDB 放 SSD,机械盘做数据盘时性能差别很大)。 - keyring 不用手工复制。新版 PVE 在界面添加 RBD 存储时自动生成并维护
/etc/pve/priv/ceph/*.keyring,只要 Monitor 地址与认证信息填对即可。 - 网络要分开。这套 2018 年的环境 public 与 cluster 网络是一个网段,生产上我们会强制拆成两个:前端业务网 + 后端复制网,避免重建流量把业务带宽吃干。
- 备份另算一层。Ceph 三副本防的是硬件故障,防不了误删与勒索;现在交付会加 Proxmox Backup Server(或 vzdump 定期任务 + 异地副本),备份与副本是两件事,不能相互替代。
- 集群规模与仲裁。三节点是最小可用规模,但两节点故障就失去 quorum;节点多了建议配 QDevice 做仲裁,避免网络分区时整个集群停摆。
2026 年发布说明:本文为 2018 年现场笔记整理,命令与界面以 PVE 3.4 / Ceph Hammer 为准;原文的拼写与全角符号错误(pveceph install –version、roo@、Monitor: 0.0.51)已按上下文修正,操作顺序未改动。需要三节点超融合的规划、部署与迁移评估,见 Proxmox 虚拟化方案;配套案例见 三节点 Proxmox + Ceph 超融合交付现场。